ML Selector
Assistente que traduz perguntas em português para consultas de leitura, útil quando a base de dados tem muitas tabelas e colunas.
Problema
Consultar dados numa base grande, com muitas tabelas e colunas, obriga a conhecer o esquema e a escrever SQL. Quem precisa de respostas rápidas perde tempo a descobrir onde está cada informação.
Abordagem
A parte difícil não é escrever o SELECT, é decidir onde procurar. Cada pergunta começa por um seletor que corre na própria máquina: um modelo de embeddings multilingue (paraphrase-multilingual-MiniLM-L12-v2, via sentence-transformers) compara o português da pergunta com a descrição e o DDL de cada tabela do dicionário e mede a proximidade entre os dois.
Só a semântica não chega, porque os nomes das tabelas raramente se parecem com a linguagem de quem pergunta. O score final junta três sinais — proximidade semântica, palavras-chave com sinónimos em português e a intenção de domínio detetada na frase — e aplica o que se sabe sobre a forma do esquema: as vistas e as tabelas centrais de cada domínio sobem, as de log, auditoria e apoio descem. Depois há um corte dinâmico que compara o primeiro classificado com o segundo: quando existe um vencedor claro segue só uma tabela, quando há dúvida seguem até três.
Cada tabela escolhida vai para um modelo de linguagem servido por Ollama (gpt-oss:120b, através da API compatível com OpenAI) que recebe apenas o DDL dessa tabela e gera o SQL com temperatura zero; os pedidos correm em paralelo, um por tabela. O backend não confia no texto devolvido: valida a consulta e executa só leitura. E se as bibliotecas de embeddings não carregarem, o seletor continua a responder em modo de palavras-chave em vez de deixar a aplicação em baixo.
Resultado
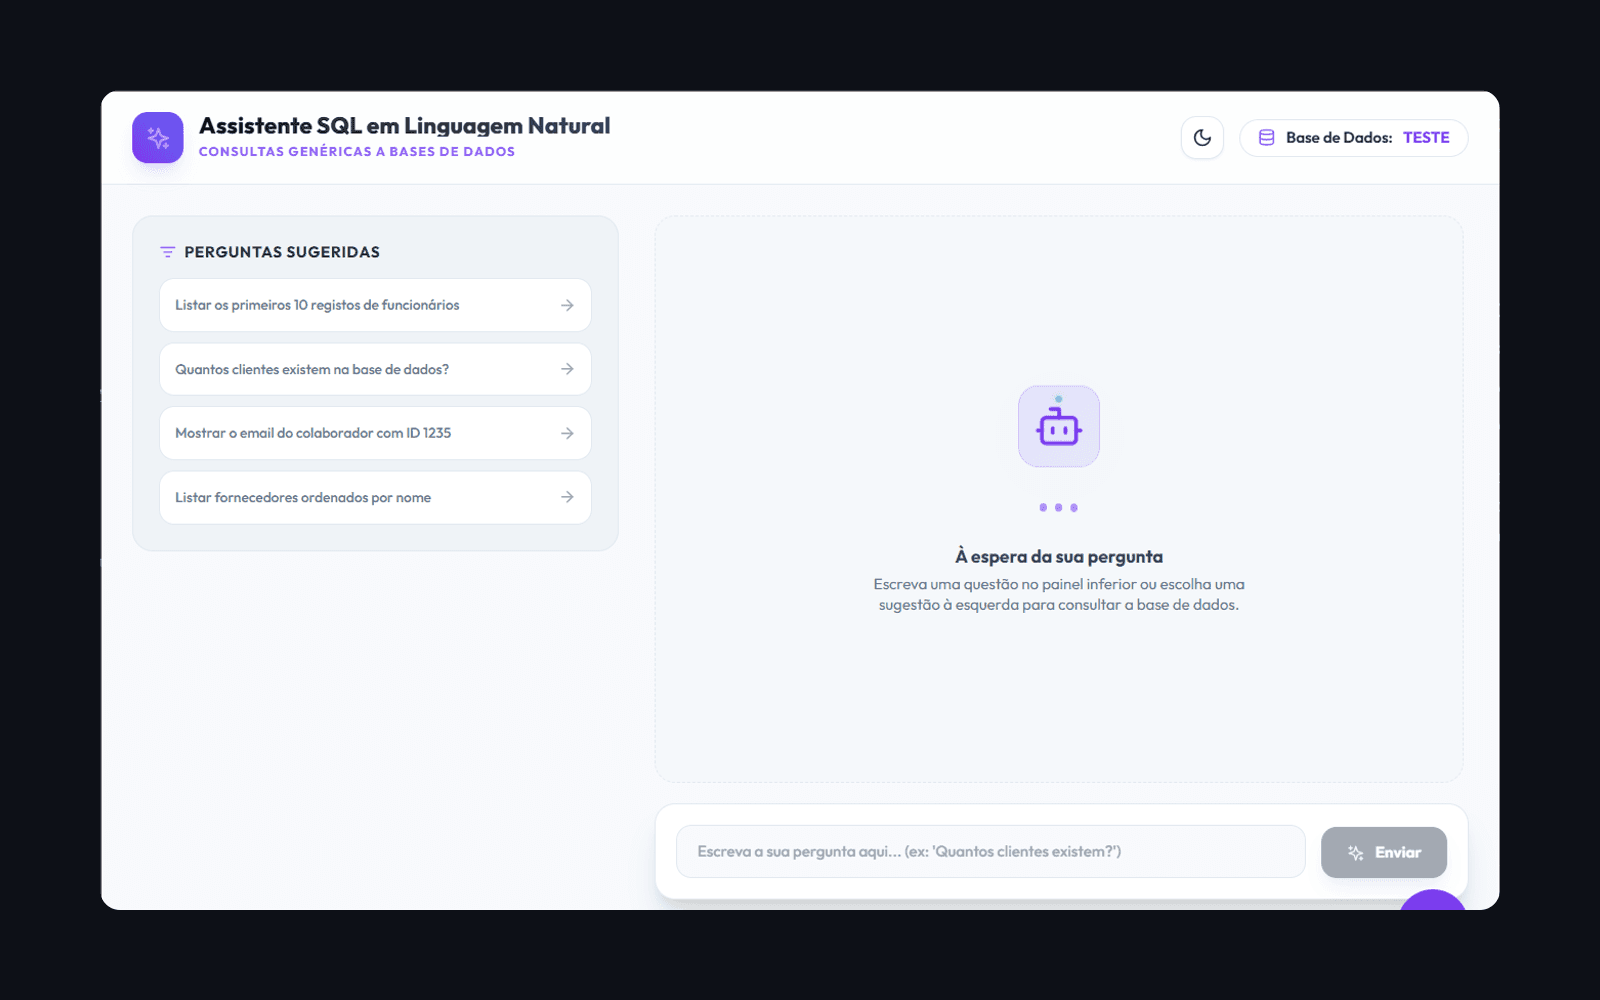
Concluído. A aplicação mostra as tabelas escolhidas com o respetivo score, o SQL gerado e os resultados numa grelha, e cada resposta pode ser marcada como útil ou inútil, com indicação da tabela correta quando a escolha falha. Esse feedback é guardado em JSONL e volta a entrar no ranking: em perguntas semelhantes, as tabelas que funcionaram sobem e as que falharam descem, sem precisar de re-treinar o modelo. O frontend é genérico, não identifica o motor nem o esquema real, e existe também uma versão de ambiente de trabalho em Tauri.